KI-gestützte Entwicklung mit Quality Gates
Für die EEF haben wir eine Web-App für Flurstückeigentümer:innen gebaut und parallel dazu eine AI-Pipeline drum herum. An diesem Produkt konnten wir im produktiven Betrieb zeigen, dass AI-Native-Entwicklung Produktionsqualität trägt.
- Erneuerbare Energien
- AI-Native Entwicklung
- Compliance & Datenschutz
- Team-Aufbau & Enablement
- Quality Gates
- Requirements Engineering
- Personas
- LAUFZEIT
- Mai 2026 bis heute
- Prototyp-Phase sechs Wochen, seither Pilotierung im produktiven Betrieb
- TEAM
- Zweiköpfiges Kernteam
- Senior-Softwareentwicklerin und Product Ownerin, punktuell verstärkt
- BRANCHE
- Erneuerbare Energien
- Projektentwicklung, Genehmigung, Bau sowie Betrieb von Hybridparks
- ROLLE
- Aufbau einer AI-Native-Entwicklungspipeline
- samt dem Produkt, an dem sie sich beweisen musste
- VORGEHEN
- Spec → Critic → Gate → Code → Review
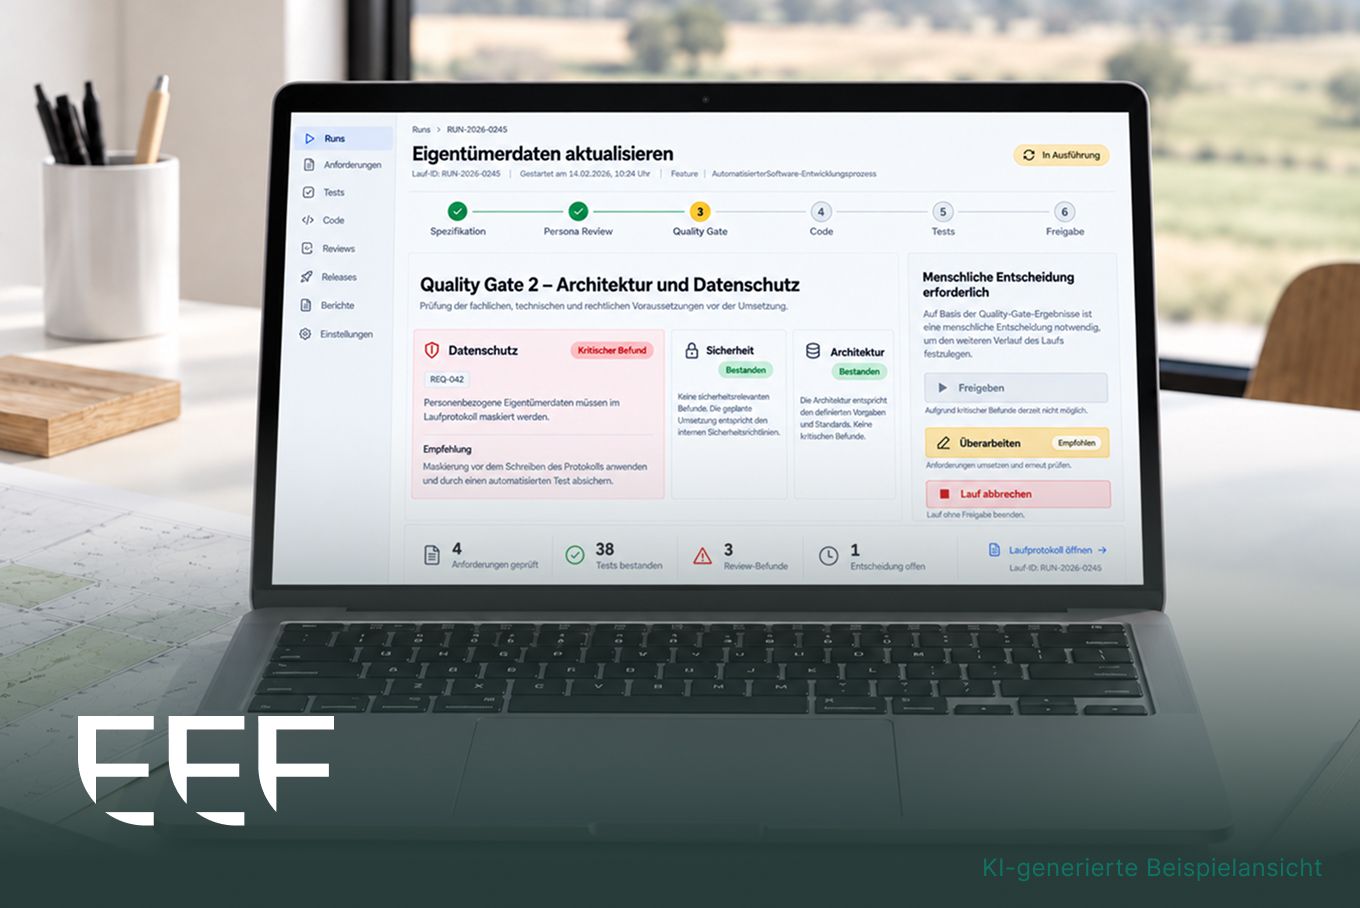
- Vier Quality Gates, an jedem entscheidet ein Mensch
- NACHWEIS
- 245 dokumentierte Läufe
- 631 Persona-Prüfpässe, 26 begründete Architekturentscheidungen
Für den Auftrag haben wir eine produktive Web-App in AI-Native-Entwicklung gebaut. Jeder Schritt lief AI-getrieben, von der Anforderungsanalyse über Spezifikation und Architekturplanung bis zu Implementierung und Review. Dazu kommt die Maschinerie, die das verantwortbar macht: verbindliche Specs mit rückverfolgbaren Anforderungs-IDs, gegnerische Persona-Reviews und vier Quality Gates mit menschlicher Entscheidung. Hinzu kommen die Testpflicht vor dem Code und ein Protokoll über jeden einzelnen Lauf.
Der Kunde stand vor einer Frage, die derzeit jede Entwicklungsorganisation beschäftigt. AI-Werkzeuge schreiben Code, und das sichtbar schnell. Offen war, ob dieser Code über einen Klickdummy hinaus trägt und woran man erkennt, dass man dem Ergebnis trauen darf. Kein Team liest die Ausgabe eines Modells Zeile für Zeile nach. Vertrauen kann also nicht aus Lektüre kommen, es muss aus Struktur kommen. Unser Auftrag war deshalb zweiteilig: eine App und eine zugehörige Kontrollstruktur, an der sich zeigen lässt, dass die App verantwortbar entstanden ist.
Fachlich gehörte zur App auch, personenbezogene Daten von Grundstückseigentümer:innen zu verarbeiten. Datenschutz war hier ein Abbruchkriterium. Dazu kamen ein knappes Zeitfenster für die Prototyp-Phase und ein zweiköpfiges Kernteam mit sehr unterschiedlichen technischen Profilen.
Unser Outcome
Unsere Qualitätsstandards standen längst fest: Reviews, Testabdeckung, begründete Entscheidungen. Die Aufgabe war, sie in eine Arbeitsweise zu übersetzen, in der kein Mensch mehr jede Zeile schreibt, und dabei keinen Millimeter von ihnen abzurücken. Die Zahlen darunter belegen, dass die Übertragung gelungen ist.
6 Wochen
Prototyp-Phase vom Kickoff bis zur produktiv nutzbaren Web-App, mit einem zweiköpfigen Kernteam
631 Persona-Prüfpässe
jede substanzielle Entscheidung von mindestens drei gegnerischen Rollen geprüft, bevor ein Mensch sie freigab
>2.100 Tests
automatisiert und unter Red-Green-Refactor-Zwang vor dem Code geschrieben, dazu 24 End-to-End-Tests
Die AI-Pipeline hinter der Web-App: vier Teile, die zusammenwirken
Die Pipeline besteht aus vier Teilen, die zusammenwirken. Der erste ist eine verbindliche Beschreibung dessen, was entstehen soll. Sie steht fest, bevor gebaut wird. Der zweite sind unabhängige Prüfinstanzen, die jedes Ergebnis gegenlesen. Der dritte sind feste Grenzen, die die Maschine nicht selbst verschieben kann. Der vierte ist eine Aufzeichnung, die jeden Schritt im Nachhinein nachvollziehbar macht.
Jeder dieser Teile schließt eine Lücke, die entsteht, sobald niemand mehr Software Zeile für Zeile von Hand schreibt. Keiner wirkt ohne die anderen drei. Eine Vorgabe ohne Prüfung wird ignoriert, eine Prüfung ohne Grenzen läuft endlos. Und was nicht aufgezeichnet ist, lässt sich später weder belegen noch verbessern.
Keine Zeile Code ohne Anforderungs-ID
Jede Anforderung einer Spezifikation trägt eine Nummer. Das gilt für funktionale Anforderungen, Qualitätsanforderungen und Randfälle. Die Nummern ziehen sich durch alles, was daraus entsteht: Tests, Commit-Messages, Pull-Request-Beschreibungen, Laufprotokolle. Code, der sich auf keine ID zurückführen lässt, gehört nicht ins Feature und wird entfernt.
Dahinter steht eine härtere Regel. Tut der Code etwas, was die Spec nicht hergibt, korrigieren wir zuerst die Spec und dann den Code. Andernfalls reproduziert die nächste Generierung denselben Fehler, weil die Vorlage ihn immer noch enthält. Die Spec ist der Vertrag, an dem korrigiert wird. Der Code ist Output, der sich jederzeit neu erzeugen lässt.
Darin liegt der praktische Unterschied zwischen einem Prompt und einer Spezifikation. Ein Prompt ist vergessen, sobald die Antwort da ist. Eine Spezifikation überlebt die Generierung, die aus ihr entstanden ist. Beim nächsten Mal lässt sie sich wiederverwenden, prüfen und gegen das Ergebnis halten.
Persona-Reviews: gegnerische Prüfrollen für jede Entscheidung
Wir haben eine Bibliothek fester Prüfrollen aufgebaut: Pragmatismus, Architektur, Risiko, Datenschutz, Sicherheit, Nutzerführung, Gestaltung. Jede substanzielle Entscheidung durchläuft mindestens drei davon, ob Spezifikation, Architekturentscheidung oder fertiger Code. Mindestens eine Rolle muss kritisch besetzt sein. Welche Rollen greifen, folgt festen Regeln: Alles mit Authentifizierung zieht Sicherheit, alles mit personenbezogenen Daten zieht Datenschutz.
Diese Prüfer widersprechen sich, und das ist ihr Zweck. 57-mal war der Widerspruch so ausgeprägt, dass ein eigener Konsolidierungsschritt nötig war. Er bündelt Übereinstimmungen, Konflikte und offene Fragen zu einer Entscheidungsvorlage und entscheidet ausdrücklich nicht selbst. Entschieden hat ein Mensch.
Ein Modell, das seinen eigenen Output bewertet, bestätigt ihn. Es hat den Text gerade selbst erzeugt und hält ihn folgerichtig für plausibel. Brauchbar werden die Befunde erst, wenn es aus einer festgelegten Rolle heraus prüft und den ausdrücklichen Auftrag hat, Schwächen zu finden.
Budgets und Git-Hooks: Grenzen technisch erzwingen
Pro Aufgabe gelten fünf Selbstheilungsrunden und dreißig Minuten ohne sichtbaren Fortschritt. Danach ist Schluss. Es folgen eine strukturierte Zusammenfassung und die Übergabe an den Menschen. Ausdrücklich untersagt ist, sich selbst neues Budget zuzuweisen oder Schleifen so zu verschachteln, dass die Zählung umgangen wird.
Wo sich eine Regel technisch erzwingen ließ, haben wir sie erzwungen und es nicht beim Aufschreiben belassen. Force-Push, das Umgehen der Commit-Hooks und der Direkt-Push auf den Hauptzweig sind auf Werkzeugebene gesperrt. Ein Pre-Commit-Hook blockiert jeden Commit an Code, zu dem kein frisches Laufprotokoll vorliegt. Wer den Prüfpass nicht dokumentiert, kann nicht committen.
Falscher Code ist bei agentischen Systemen der billigere Fehler, denn er fällt im Test auf. Teuer wird der Agent, der eine Sackgasse nicht als Sackgasse erkennt und weiter iteriert. Er tut das plausibel begründet, unermüdlich und auf Kosten, die niemand bemerkt, solange niemand hinschaut.
Eval-Suite mit automatischen Judges: Wir testen auch den Agenten
Für die Pipeline selbst gibt es eine eigene Prüfstrecke. Sechs Aufgaben mit automatischen Judges messen, ob der Agent sich an die eigenen Regeln hält. Sie prüfen, ob er die Spezifikation schreibt, bevor er codet, und ob er den Prüfpass ausführt. Sie prüfen außerdem, ob er das bestehende Design-System nutzt, statt eine eigene Komponente zu erfinden, und ob er der festgelegten Anredeform treu bleibt.
Dazu kommen Post-Mortems, wenn die Pipeline versagt. Dreimal haben wir eines dokumentiert. In einem Fall wurde ein Code-Review übersprungen, weil ein Hook fehlte. Als Konsequenz haben wir den Hook ergänzt und es nicht bei „künftig besser aufpassen“ belassen.
Regeln, die man einem Agenten gibt, sind Behauptungen, bis man sie prüft. Das gilt umso mehr, je länger die Anweisungsdatei wird. Was in Absatz vierzig steht, übergeht ein Agent unter Druck genauso wie ein Mensch.
„Anfangs musste ich mich erst im Umgang mit Git zurechtfinden. Die Pipeline musste so gebaut sein, dass ich nichts kaputtmachen konnte. Nach drei Wochen habe ich Use Cases innerhalb weniger Stunden eigenständig umgesetzt und produktiv gestellt, ohne dafür ein:e Entwickler:in zu brauchen.“
Unser Vorgehen in der AI-Native-Entwicklung
Die Wissensbasis wird kuratiert, nicht angebunden
Die internen Wissenssysteme des Kunden sind bewusst nicht an die AI-Werkzeuge angeschlossen. Es gilt ein Pull-Prinzip: Fehlt dem Agenten Kontext, fragt er ausdrücklich danach, und ein Mensch liefert den geprüften Auszug in die Wissensbasis des Projekts.
Das kostet Zeit, in jeder einzelnen Sitzung, und es ist die unbequemere Variante. Dafür bekommen wir zweierlei. Aus den Kundensystemen fließt nichts unkontrolliert ab, und das ist bei personenbezogenen Daten die Grundbedingung. Und in der Wissensbasis steht nur, was jemand geprüft hat und was für den Produkt-Case relevant ist. Das spart Token.
Das Iterationsbudget bricht Läufe ab, auch kurz vor dem Ziel
Das Iterationsbudget bricht auch Läufe ab, die kurz vor dem Ziel zu stehen scheinen. Im Einzelfall fühlt sich das jedes Mal falsch an, denn der nächste Versuch wirkt immer wie der, der es löst.
Über 245 Läufe hinweg verhindert genau das, dass ein Agent stundenlang an einer Fehlannahme weiterarbeitet. Der Abbruch übergibt an die Instanz, die die Fehlannahme erkennen kann: einen Menschen mit Kontext. Ein Scheitern ist er deshalb nicht.
Post-Mortems: Die Pipeline hat sich an ihren Pannen korrigiert
Wenn die Pipeline versagt hat, haben wir das Versagen analysiert und nicht umgangen. Dazu gehörten eine Ursachenanalyse und eine Maßnahme, die den Fehler strukturell unmöglich macht. Aus einem übersprungenen Code-Review wurde ein Hook, aus einem ignorierten Pfad eine Prüfung vor dem Commit.
Bemerkenswert ist die Richtung dieser Korrekturen. Sie liefen fast nie auf „mehr Anweisung“ hinaus, in aller Regel auf „weniger Möglichkeit“. Was ein System technisch nicht zulässt, muss niemand disziplinieren.
AI-Pipeline
 Claude Code
Anwendung
 TypeScript strict
 React Native
 Expo
- Expo Router
 TanStack Query
Backend
 Bun
 Hono
 Drizzle
 Zod
 PostgreSQL
Betrieb
 Vercel
 Neon Postgres in EU-Region
 GitHub Actions
Qualität
 Vitest
 Jest
 React Native Testing Library
 ESLint
 Prettier
- tsc strict