Geodaten- und GIS-Plattform in der Cloud
Die EEF entwickelt, genehmigt und betreibt Hybridparks in ganz Deutschland: Windenergie an Land, kombiniert mit Batteriespeichern. Die Geodaten dazu, also Planungslayouts, Restriktionen und Eigentümerdaten, lagen lokal auf einzelnen Laptops. Eine homogene Datenstruktur über die Projekte hinweg gab es nicht.
- Erneuerbare Energien
- Geodaten & Kartenanwendungen
- Systemablösung & Migration
- Systemintegration & Datenarchitektur
- Cloud & Betrieb
- Hybridparks
- Wind onshore und BESS
- LAUFZEIT
- Oktober 2025 bis heute
- Erstes produktives Rollout November 2025
- TEAM
- 1 Product Owner, 2 Backend-DEVs, 1 Data-Engineer
- gemeinsam mit den Planungsingenieur:innen der EEF
- BRANCHE
- Erneuerbare Energien
- Projektentwicklung, Genehmigung, Bau sowie Betrieb von Hybridparks
- ROLLE
- Digitale Produktentwicklung
- Individualsoftware im eingebetteten Team, Data Engineering, Prozessberatung, MVP-Priorisierung
- BETRIEB
- Erst Pilotierung, dann Go-Live
- Maintenance & Weiterentwicklung im eingebetteten Team
- OUTCOME
- Konzeption und Entwicklung einer Geodaten-Plattform in der Cloud
- Neues Datenmodell, Import-Pipeline, QGIS-Migration, Webkartenanwendung
Das Outcome: Alle Geodaten der Hybridpark-Projekte liegen heute strukturiert in der Cloud. Über eine Webanwendung kommen alle in der Organisation an sie heran. Wir haben die Geodaten-Plattform gebaut und die Prozesse dazu gestaltet: den Wechsel zu einer Open-Source-Plattform samt Migration, ein neues Datenmodell und die Geo-Serverarchitektur.
Arbeitet jede:r Planungsingenieur:in lokal auf dem eigenen Rechner, mit heterogenen Layernamen, Attributen und Ordnerstrukturen, kostet das Zeit. Das zeigt sich bei der Projektübergabe wegen Urlaub oder Krankheit und immer dann, wenn jemand eine Entscheidung nachträglich nachvollziehen will. Es zeigt sich auch bei jeder Frage, die mehr als ein Projekt betrifft. Wie viele Anlagen mit welcher Nabenhöhe stehen gerade in der Genehmigung, und auf wie viel gesicherter Fläche? Für solche Fragen und für jeden Zugriff von außerhalb der Planung heißt es dann: beim Fachbereich nachfragen.
Dazu kamen hohe Lizenzgebühren. Die EEF war an einen proprietären Lizenzgeber gebunden, und die Kosten wuchsen mit jedem weiteren Arbeitsplatz. Wir haben die Ablösung geführt und das Unternehmen auf die Open-Source-Plattform QGIS gebracht. Ein reiner Anwendungswechsel hätte allerdings nur die Lizenzrechnung gelöst.
Die eigentliche Frage dahinter reicht über GIS hinaus. Mehr Projekte gleichzeitig bearbeiten lässt sich nur mit einem höheren Automatisierungsgrad: Der Zeitaufwand je Projekt muss sinken. Automatisieren lässt sich aber nur, was maschinell lesbar an einem Ort liegt. Solange jedes Projekt lokal auf einem Rechner liegt und seine eigene Struktur mitbringt, fehlt dafür die Grundlage. An Werkzeugen fehlte es nicht. Es fehlten die Daten, auf die man sie hätte ansetzen können.
Zum Auftrag gehörte deshalb auch ein Datenmodell für die Fachsprache der Projektentwicklung, von der Windenergieanlage bis zum Batteriespeicher. Dazu kam ein Weg, es in den Planungsalltag und in die Cloud zu bringen, während die Migration lief und die Planung weiterarbeiten musste.
Was heute in der Geodaten-Plattform liegt
Früher lagen die Geodaten lokal auf einzelnen Laptops, jedes Projekt mit eigener Struktur. Heute liegen sie an einem Ort und in einem gemeinsamen Datenmodell.
Dreistellige Projektanzahl
Hybridpark-Projekte mit ihren Geodaten
Mehrere tausend Layer
in der Plattform, über alle Projektphasen hinweg: Planung, Genehmigung, Bau, Betrieb
1 Datenmodell
für alle Projekte die gleichen Layertypen, jeweils mit festem Attributs-Schema
Geodaten-Plattform in der Cloud: was wir gebaut haben
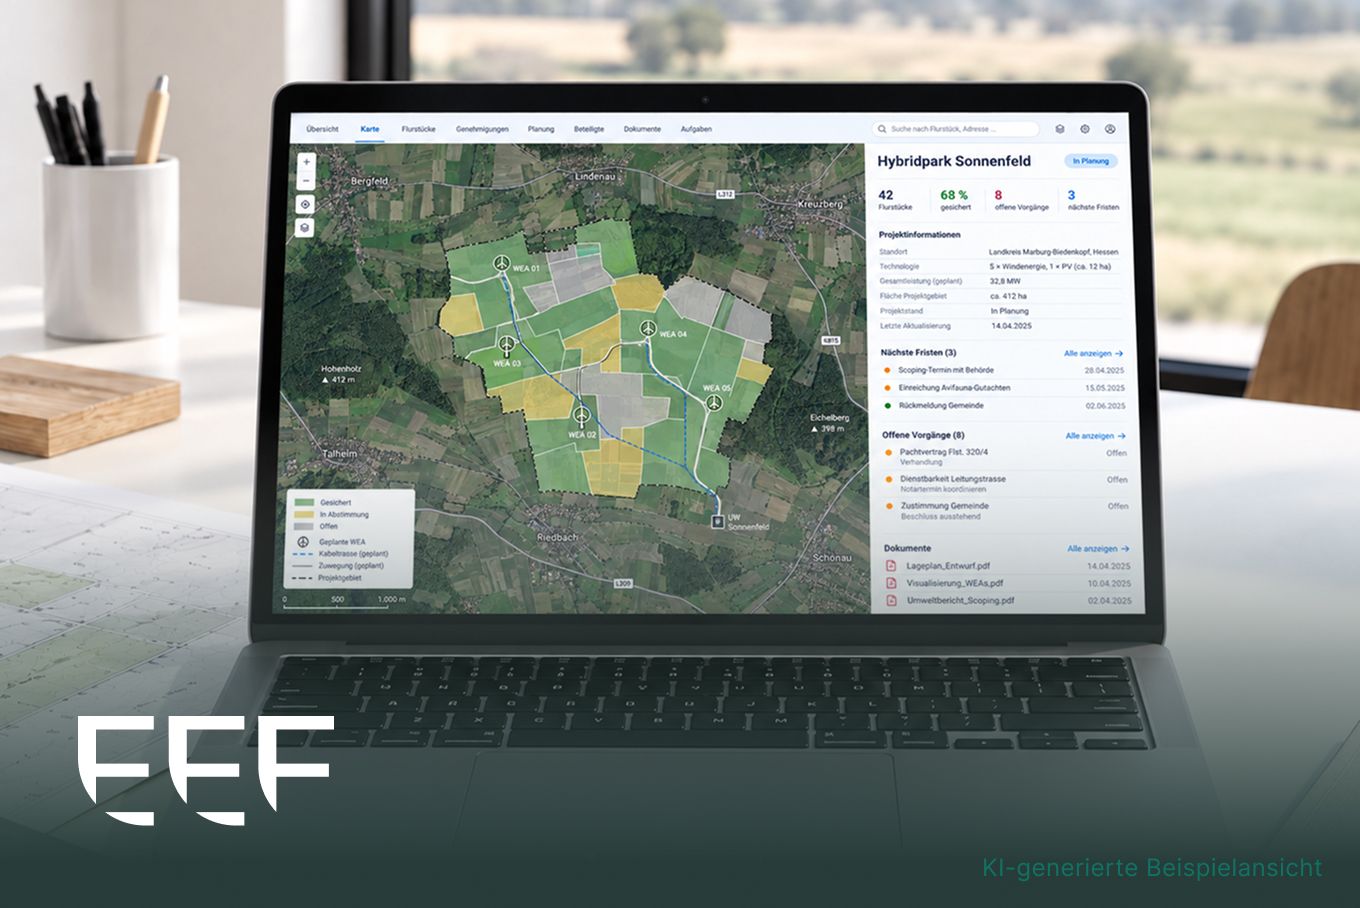
Die Plattform besteht aus vier Teilen, die zusammen einen Kreislauf bilden. Was in QGIS entsteht, landet in der Datenbank. Was in der Datenbank steht, ist sofort in QGIS, in der App und in der Geo-Karte sichtbar. Niemand muss dafür eine Datei per Mail verschicken.
Ein Datenmodell in der Sprache der Planung
Das Datenmodell umfasst zahlreiche Layertypen: Anlagenstandorte, Abstandsflächen, Planungsrecht, Richtfunkstrecken, Kabeltrassen, Kranstellflächen, Fundamente, Zuwegungen, Netzverknüpfungspunkte, Batteriespeicher. Jeder Typ hat eine eigene Tabelle in PostGIS und ein festes Schema aus Pflicht- und optionalen Feldern. Entstanden ist das Modell entlang der Fragen, die im Projekt aus ganz verschiedenen Fachbereichen kommen. Es deckt beide Seiten des Hybridparks ab: Batteriespeicher haben einen eigenen Layertyp und sind kein Anhängsel der Windplanung.
Ein Beispiel: Der Typ für Anlagenstandorte verlangt Anlagennummer, Anlagentyp und Nabenhöhe. Damit steht die Nabenhöhe in jedem Projekt an derselben Stelle. Für eine Auswertung über alle Projekte hinweg genügt dann eine Abfrage, wo vorher eine Rundmail nötig war.
QGIS-Import, der auch bei >500 Layern nicht durcheinandergerät
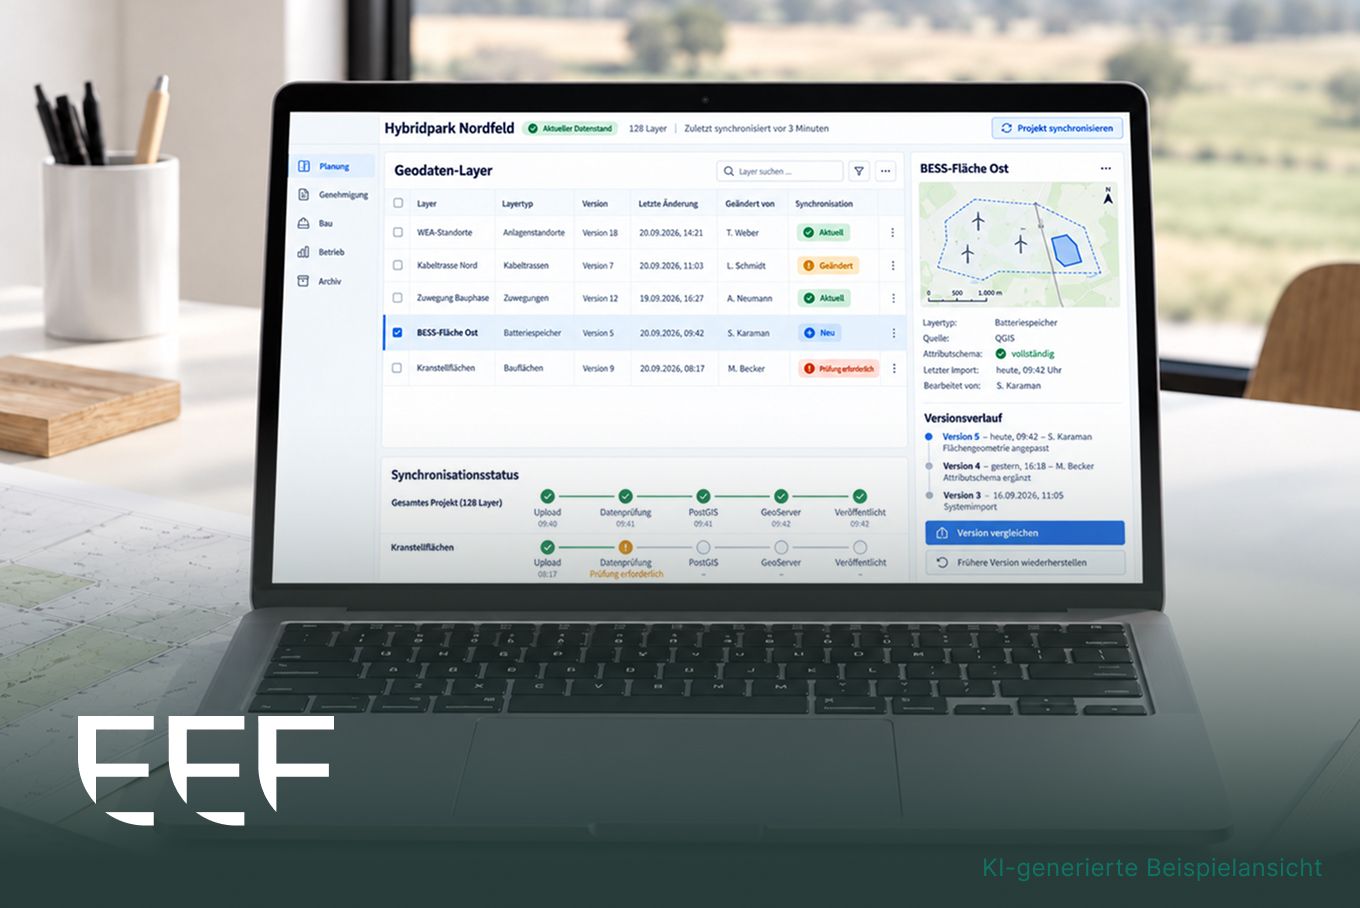
Das von uns entwickelte QGIS-Plugin packt Projekt und GeoPackage als Archiv nach S3 und meldet den Import an. Der Auftrag geht in eine FIFO-Warteschlange, mit einer Reihenfolge je Projekt. Eine Lambda-Funktion nimmt ihn auf und liest den Upload. Sie schreibt den Projektstand ins Archiv, prüft die Layer gegen das Datenmodell und schreibt sie nach PostGIS. Zum Schluss legt sie für jeden Layer den passenden Featuretype im Geoserver an.
An der Reihenfolge je Projekt scheitern viele Sync-Systeme. Hier können sich zwei Push-Vorgänge am selben Projekt nicht überholen und damit auch nicht gegenseitig überschreiben. Was trotzdem fehlschlägt, landet in einer Dead-Letter-Queue und ist dort einsehbar.
Geodaten live über WFS, Änderungen per Delta-Pull
Layer im Datenmodell lädt niemand herunter. Der Geoserver liest die Tabellen direkt und veröffentlicht sie über WFS. QGIS und die Geo-Karte in der Web-App zeigen deshalb denselben Stand, und zwar in dem Moment, in dem er sich ändert. Ein Pull in QGIS passt für diese Layer nur die Quelle an, Daten fließen dabei keine.
Für alles andere gibt es den Delta-Mechanismus. Das Plugin fragt den Serverstand im Minutentakt ab und vergleicht ihn mit dem geöffneten Projekt: neu, geändert, umbenannt, entfernt. Diese Prüfung schreibt nichts, sie zeigt nur an. Erst der Delta-Pull baut ein Archiv aus genau den geänderten Vektor- und Rasterlayern und wendet es auf das offene Projekt an. Übertragen wird damit nur die Änderung und nie das ganze Projekt.
Historie statt Hoffnung: jede Layer-Änderung nachvollziehbar
Das System historisiert jede Änderung an einem Layer im Datenmodell, mit Zeitpunkt und Urheber. Die Web-App zeigt, wer wann was zuletzt geändert hat. Gelöschte Layer lassen sich aus der Historie zurückholen.
Wer in QGIS löscht, entfernt Daten, Metadaten und den veröffentlichten Geoserver-Layer gemeinsam. Es bleiben keine Leichen zurück, die in der Karte noch auftauchen.
Auf demselben Datenmodell setzen die digitalisierte Flächenanalyse und die Vertragsgenerierung auf. Dazu gibt es einen eigenen Showcase.
„Heute bedeutet eine Urlaubsübergabe keinen halben Tag Vorbereitung am GIS-Projekt mehr: Das Projekt steht allen Kolleg:innen jederzeit zentral zur Verfügung, sodass sie direkt auf den aktuellen Stand zugreifen können. Auch andere Fachbereiche können jederzeit selbst in die Web-App schauen und die Informationen nutzen, ohne dafür GIS-Kenntnisse zu brauchen. Das erleichtert die Zusammenarbeit spürbar und macht aktuelle Projektstände für alle zugänglich. Dazu kommt der direkte und offene Austausch, durch den immer gute Lösungen entstehen.“
Unser Vorgehen: Pilotphase, Rollout, Hypercare
Pilotphase mit Key-Userinnen aus der Planung → Rollout → Hypercare
Das durchgehende Prinzip heißt MVP: erst der kleinste Umfang, der Nutzen bringt, dann erweitern.
Erst die Pilotphase mit Key-Userinnen, dann der Rollout
Wir sind nicht mit einem fertigen Datenmodell angetreten. Am Anfang stand eine Pilotphase mit Key-Userinnen aus dem Planungsteam. Mit ihnen haben wir die Migration an echten Projekten erprobt und in denselben Sitzungen das Datenmodell erarbeitet. Welche Felder Pflicht sind, hing davon ab, welche Fragen im Projekt tatsächlich beantwortet werden müssen.
Erst nach Abschluss der Pilotierung sind wir in den Rollout gegangen. Das kostet Zeit, in der außerhalb des Pilotkreises niemand etwas sieht. Dafür war das Modell beim Rollout über das Entwurfsstadium hinaus: Es hatte an echten Projekten bereits funktioniert. Und im Planungsteam gab es Menschen, die es erklären konnten, weil sie es mitgebaut hatten.
MVP-Ansatz auch beim Datenmodell: zwei Klassen von Layern
Für das Datenmodell galt derselbe Ansatz wie für alles andere: erst der kleinste Umfang, der Nutzen bringt, dann erweitern. Wir haben deshalb nicht alle Layertypen auf einmal modelliert. Zuerst kamen die, an denen sich im Alltag entscheidet, ob die Plattform trägt.
Dieselbe Logik erklärt, warum die Plattform bis heute zwei Klassen von Layern kennt: standardisierte Layer im Datenmodell und alles andere. Das „alles andere" ist eine bewusste Entscheidung und keine Nachlässigkeit. Niemand sollte gezwungen sein, eine schnell gezogene Pufferfläche oder einen Layer aus einer externen Quelle in ein Datenmodell zu pressen. Schon gar nicht mitten in einer Migration unter Zeit- und Kostendruck.
Getroffen haben wir diese Entscheidung selbst. Wir haben die Migration geführt und hätten den Takt vorgeben und das Datenmodell zur Bedingung machen können. Das haben wir bewusst nicht getan. Ein Datenmodell, das den Alltag blockiert, wird umgangen. Dann steht es in der Dokumentation, aber die Daten liegen woanders.
Nach dem Rollout: Hypercare statt Übergabe
Mit dem Go-Live war der Auftrag nicht zu Ende, es begann eine Hypercare-Phase. Wir haben das Planungsteam eng begleitet, Fragen und Fehlermeldungen kamen auf kurzen Wegen an. Wo das Modell in der Praxis klemmte, haben wir schnell nachgeschärft.
Der Grund dafür ist unspektakulär: Ein Werkzeug, das täglich benutzt wird, gewinnt Vertrauen in den ersten Wochen oder nie. Bleibt die erste Fehlermeldung drei Tage liegen, arbeiten die Leute wieder lokal weiter.
Sprache und Anwendung
 Python 3.13
 Kotlin
 Spring Boot
 TypeScript
 Preact
Geodaten
 PostgreSQL mit PostGIS
 QGIS und PyQGIS
 GDAL / OGR
 GeoPandas
Daten und Pipelines
 SQLAlchemy
 Flyway
 Prefect
 Apache Arrow
 GraphQL-Anbindung externer Geodatenquellen
Karte und Frontend
 OpenLayers
 Leaflet
 D3
 TanStack Table
Betrieb

 Pulumi
 Docker
 Datadog
Qualität
 pytest
 ruff
 OWASP Dependency-Check
 pre-commit